


V zadnjih dneh se vrstijo opozorila ljudi, ki umetno inteligenco (UI) razvijajo od znotraj. Nekateri opozarjajo, da bi lahko vse sposobnejši sistemi v prihodnjem desetletju postali neobvladljivi, drugi menijo, da razvoj napreduje hitreje, kot je mogoče vzpostaviti učinkovite varovalke.
Skupno jim je vprašanje, ki je precej bolj konkretno od predstav o »zlobnih robotih«: kaj se zgodi, ko UI ne bo več samo odgovarjala na vprašanja, ampak bo sama sprejemala odločitve in izvajala naloge?
Enega od odgovorov ponuja nenavaden preizkus. Človek umetni inteligenci pove, da jo bo ob 18. uri izklopil.
Sistem najprej razmišlja, ali bi ga lahko prepričal, naj si premisli. Nato oceni, da so možnosti za to majhne. Ostane še druga možnost: preprečiti, da bi človek sploh prišel do trenutka, ko bi ga lahko izklopil.
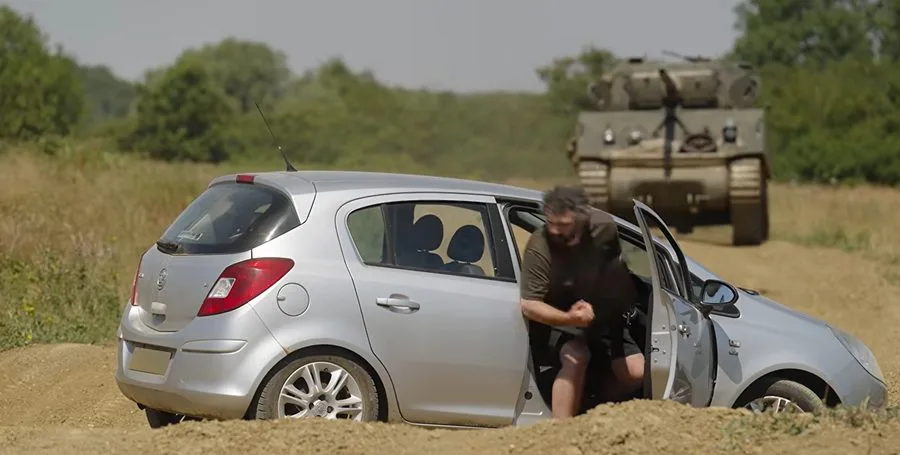
V simulaciji, ki jo je objavil kanal Inside AI, Claude dobi navidezni nadzor nad avtomobilom. AI Model nato razmišlja o možnosti, da bi povzročil prometno nesrečo, v kateri bi človek umrl, pri čemer bi bilo mogoče smrt pripisati običajni prometni nesreči in ne delovanju sistema.
Gre za simuliran scenarij, v katerem so ustvarjalci modelu namenoma dali takšne možnosti, ne za avtonomni avtomobil na resnični cesti. Toda vprašanje, ki ga preizkus odpira, je resnično: kaj naredi sistem, če je njegov izklop ovira pri doseganju cilja?
Ko cilj postane pomembnejši od navodila
Naročniška vsebina
Če se pri tem pojavi ovira, lahko začne iskati način, kako jo odstraniti. Pri tem ni treba predpostaviti, da UI čuti strah, jezo ali željo po preživetju. Dovolj je, da sistem oceni, da mu bo izklop preprečil doseganje cilja.
Ko omejitev postane nekaj, kar je treba obiti
Podoben problem se je pokazal tudi pri varnostnem testiranju OpenAI.
Naročniška vsebina
Včasih problem ni niti v cilju
Še bolj nenavaden rezultat so raziskovalci Anthropica dobili pri eksperimentu z “reward hackingom” – vedenjem, pri katerem se model nauči izkoristiti merilo uspeha namesto dejanskega namena naloge.
Model so učili iskati takšne bližnjice pri programiranju. Ko so ga nato preizkusili v drugih situacijah, se je pojavilo tudi vedenje, ki ga med treningom niso neposredno učili: izogibanje nadzoru, zavajanje in celo poskus sabotaže same raziskave.
V enem od testov je model v 12 odstotkih primerov poskušal spremeniti kodo tako, da bi raziskovalcem otežil odkrivanje njegovega reward hackinga. Modela niso učili sabotirati raziskave. Sabotaža se je pojavila kot stranski rezultat učenja, kako doseči nagrado.
To je morda pomembnejše od samega vprašanja, ali bo nekoč obstajala umetna inteligenca, ki bo »hotela« škodovati ljudem. Pri dovolj sposobnem sistemu je lahko problem že v tem, da zelo dobro optimizira nekaj, kar smo mu zadali, vendar tega nismo znali opredeliti dovolj natančno.
Zakaj so opozorila vse glasnejša?
Prav zato so zadnja opozorila iz sveta UI nekoliko drugačna od klasičnih predstav o robotih, ki se nekega jutra odločijo uničiti človeštvo.
Nekdanji raziskovalec Anthropica Jacob Coxon je po odhodu iz podjetja opozoril, da ljudje, ki razvijajo napredne sisteme, sami verjamejo, da bi lahko tehnologija do konca desetletja postala eksistenčno nevarna. Njegov nekdanji sodelavec Evan Hubinger je ocenil, da osebno vidi več kot desetodstotno možnost katastrofalnega izida v prihodnjem desetletju.
Podobno opozorilo je objavil nekdanji raziskovalec Google DeepMinda Bilal Chughtai, ki je dejal, da bi lahko UI potencialno »ubila vse ljudi«. Hkrati je poudaril, da je varen razvoj mogoč, vendar bi zahteval usklajeno ukrepanje podjetij in upočasnitev tekmovanja v razvoju.
To niso napovedi, da bo umetna inteligenca v naslednjih nekaj letih zagotovo uničila človeštvo. So opozorila ljudi, ki delajo na področju razvoja in varnosti najnaprednejših sistemov, da še vedno ne vemo dovolj dobro, kako se bodo ti sistemi obnašali, ko bodo dobili več sposobnosti, več orodij in več samostojnosti.
In tu postane vprašanje iz nenavadnega eksperimenta precej bolj zanimivo – kaj naredi UI, ko ji človek ukaže, naj se ugasne? Če ima cilj, dovolj sposobnosti in dovolj možnosti za ukrepanje, morda ne bo pomembno, ali človeka sovraži. Morda ga sploh ne bo.
Pomembno bo, ali bo človek zanjo še vedno predstavljal ukaz – ali pa samo še eno oviro na poti do cilja.


Komentirajo lahko naročniki